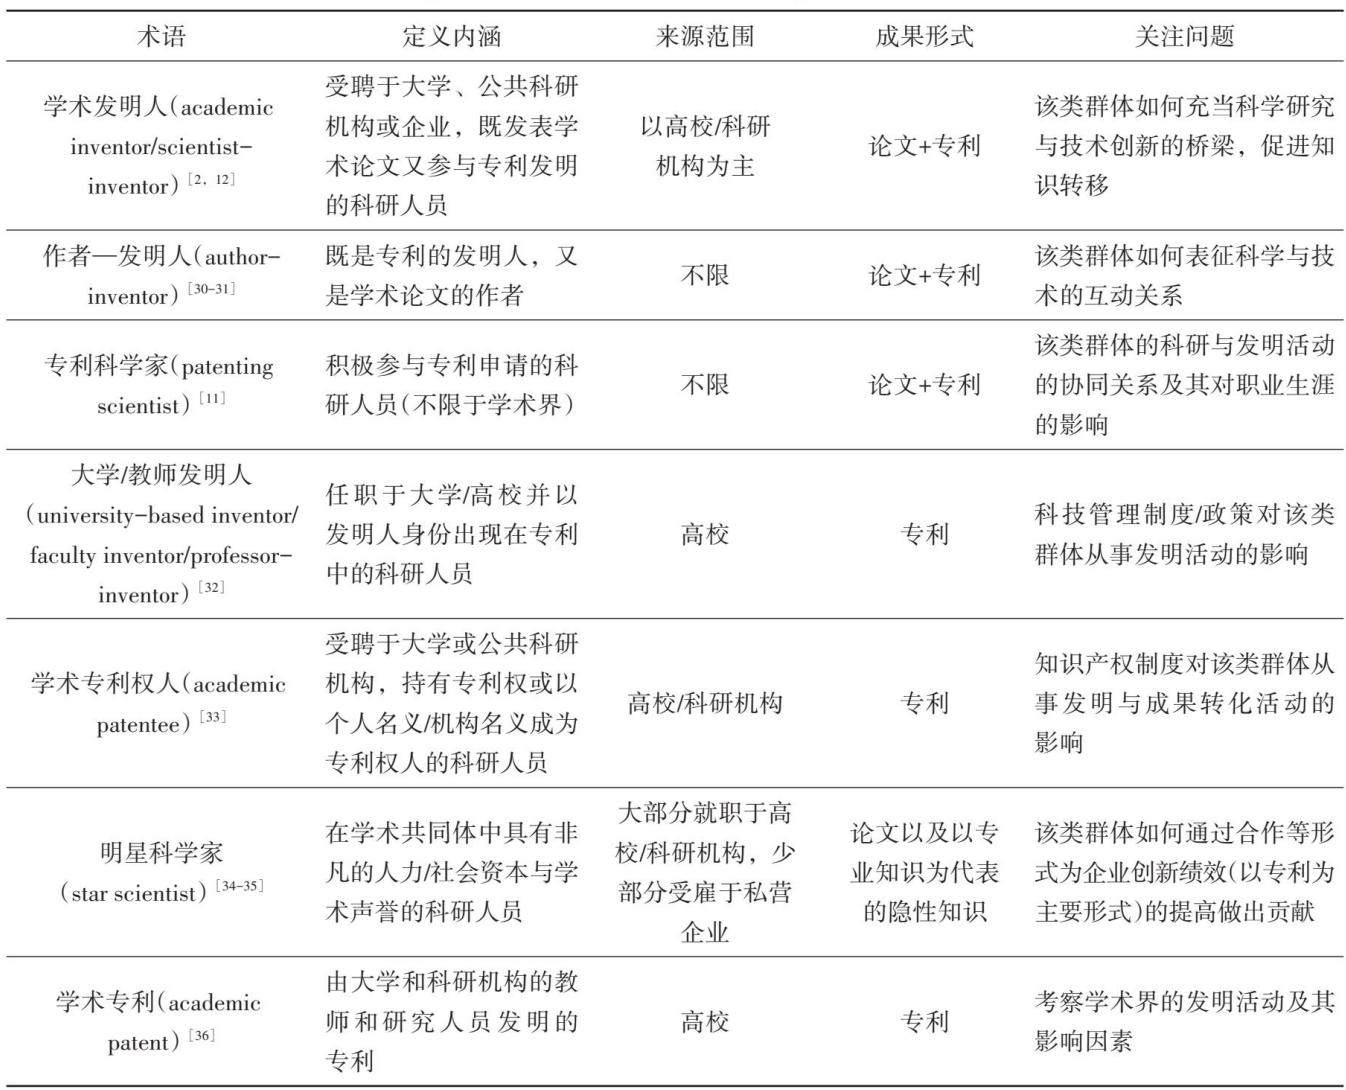
摘 要: [目的/意义] “学术发明人”兼具学者与发明家双重身份, 是连接科学发现与技术创新的关键桥梁。通过系统界定其内涵、解析制度动因与构建识别框架, 旨在为深化科技评价改革、精准人才管理与优化创新政策提供理论支撑。[方法/过程] 从概念、制度与方法3个维度展开。概念上, 基于知识生产模式2、三螺旋与学术资本主义理论, 阐释其跨界性本质; 制度上, 引入多重制度逻辑视角, 构建规制—规范—文化认知的递进式分析框架, 揭示其兴起的环境驱动机制; 方法上, 构建包含参与度、双重性与桥梁性的多维识别体系, 引入 “巴斯德象限” 模型实现精细化分类画像, 并探讨其应用场景。[结果/结论] 研究明确了学术发明人从单纯的 “二元匹配” 向 “深度特征画像” 的跨越, 不仅为破解 “破五唯” 背景下的科技评价困境提供了多维工具, 也为实施差异化人才培养和区域创新布局提供了科学依据。
摘 要:[目的/意义] 为提升科技文献图像跨模态表征中细粒度语义对齐与复杂知识理解的能力,提出了“图引句增强型”科技文献图文理解框架CE-SciVL。[方法/过程] 本文设计了基于LaTeX源码的数据自动化抽取方案,构建了“图引句增强型”科技文献图文数据集,CE-SciVL采用SciBERT+ViT双流架构,引入结构化多信号分层输入机制和语言建模损失隐式驱动策略,实现科技文献领域的图文特征对齐与语义解析。[结果/结论] 数据分析表明,图像引用句具有最高的“语义信噪比”。实验结果显示,CE-SciVL在文本生成任务中效果优于Qwen-VL、mPLUG-DocOwl等基线模型,且在SciCap上展现出较好的零样本泛化能力。消融实验证实:“图引句增强”是实现细粒度语义理解的有效范式;上下文虽包含有效信息,但其低信噪比特性会引起噪声干扰现象,未来模型须具备有效的信息筛选机制才能充分利用此类数据。
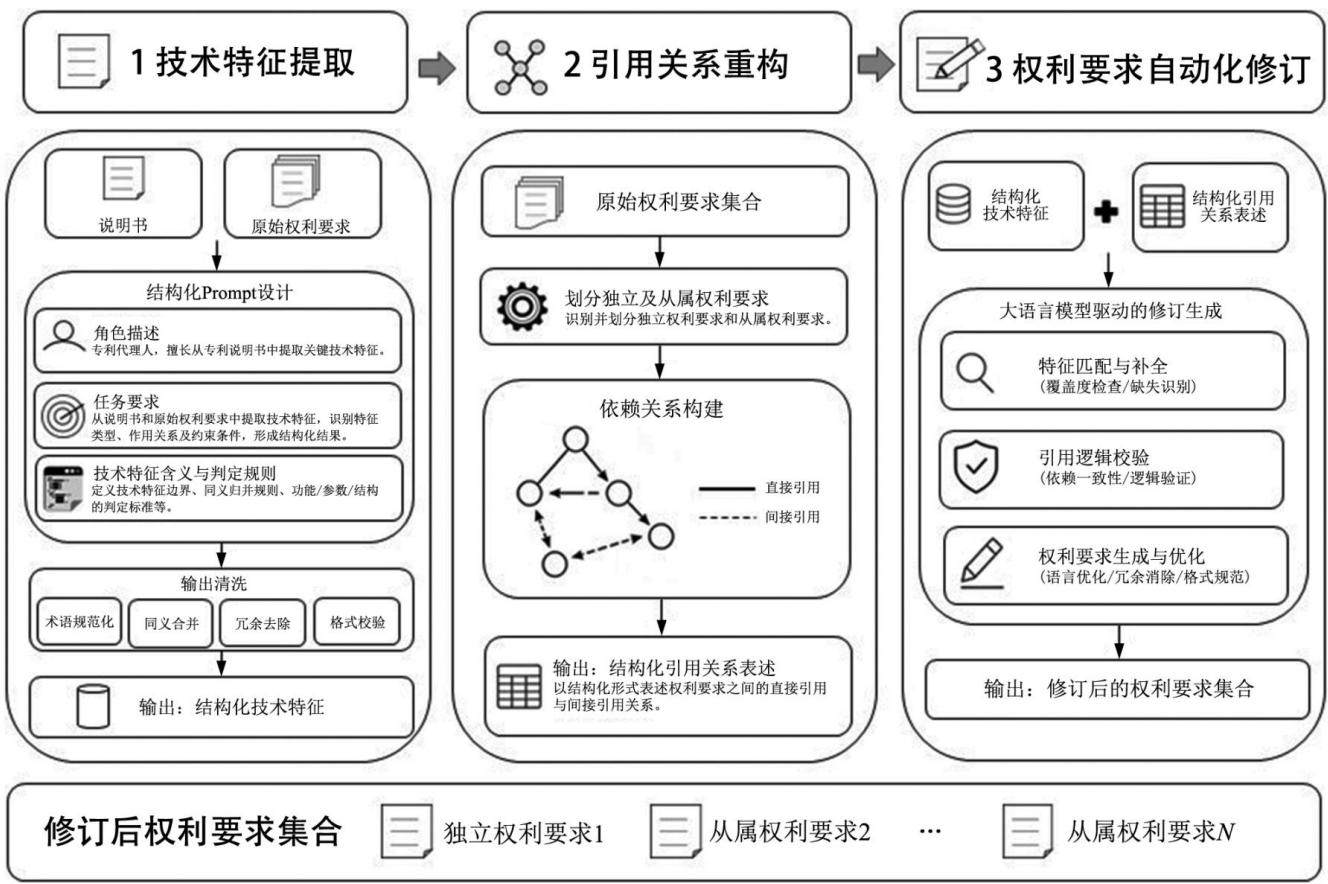
摘 要:[目的/意义] 针对专利权利要求修订中复杂逻辑关系难建模、技术事实易偏移等痛点,本研究旨在探索结构化约束与隐式思维引导在专利智能修订中的应用机制,以提升权利要求的翔实程度与法律防御效力。[方法/过程] 本文提出一种专利权利要求书的智能修订方法(Patent Feature-Extraction and Citation-Linkage Reconstruction Framework,Pat-FCL),通过规则驱动机制以及图遍历算法将权利要求间的隐性依赖转化为显式引用结构,并结合从专利说明书中提取的细粒度技术特征清单,引导大语言模型在Zero-Shot策略下实现权利要求书的修订。[结果/结论] 本文选取LLaMA-3-8B-Instruct、Flan-T5-Large、Mistral-7B-Instruct、Qwen-2-7B-Instruct作为推理基线。相比于基线模型,本文方法在SARI和ROUGE-L指标上分别最高提升了7.59和14.45个百分点,增幅分别达27.3%和25.5%,且在BERTScore与LLM-Eval等语义评价维度上均保持领先。结果表明,本文提出的专利权利要求书修订方法显著提升了修订文本的质量,有效缓解了技术特征覆盖不全、从属权利要求与独立权利要求之间法律防御梯度不够的问题,为专利的智能化撰写与质量控制提供了新的技术路径。
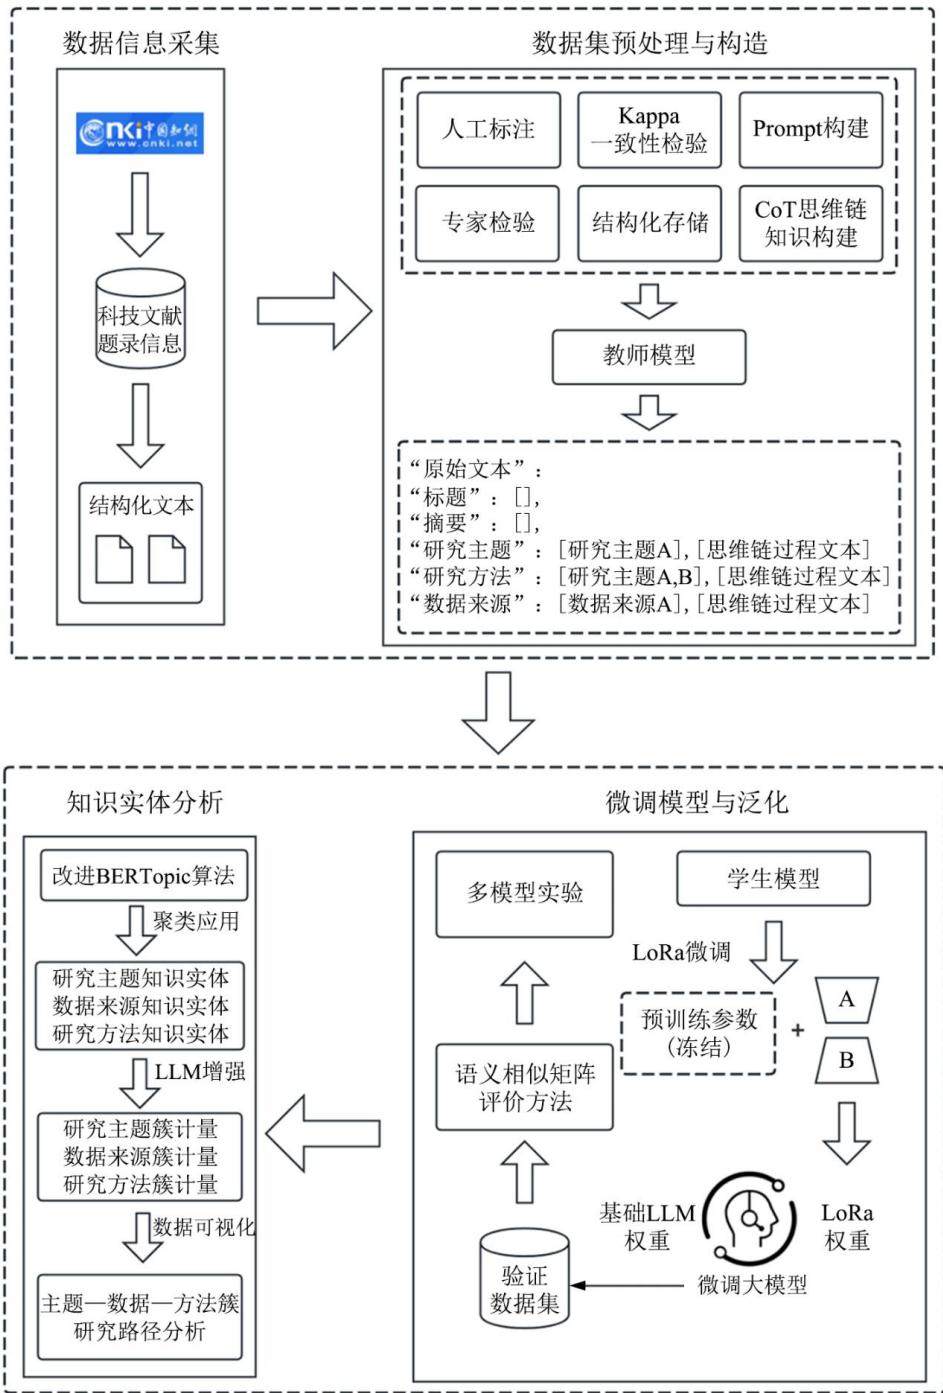
摘 要:[目的/意义] 学术文献中的知识实体是表征其价值内核的载体,对其进行自动化、高精度的挖掘与分析利用,是洞察科技情报发展态势、揭示学科演化规律的重要途径。[方法/过程] 以情报学领域11本中文核心期刊的题录信息为研究对象,融合思维链(CoT)知识蒸馏与QLoRA参数高效微调策略,借助大参数教师模型生成包含推理过程的思维链数据,将其蒸馏注入并训练轻量化的小参数学生模型中,实现知识的低耗、高效抽取;对抽取的知识实体,采用融合BGE语义表征和LLMs的BERTopic聚类分析方法,识别并归纳研究主题—数据来源—研究方法(T-D-M)三类簇及关联组合路径。[结果/结论] 实验表明,该训练策略能够显著提升学生模型的性能,但与教师模型间仍存在差距;同架构的科技领域预训练大语言模型的基础性能优于通用语言模型。以情报学领域11本核心期刊2021—2025年的9053篇文献为实证对象,开展知识聚类与关联组合分析,归纳出该领域近年来的主要研究热点与方向,绘制“研究主题—数据来源—研究方法—研究路径”分析图,揭示研究主题、数据来源、研究方法驱动的差异化研究逻辑与潜在研究组合。
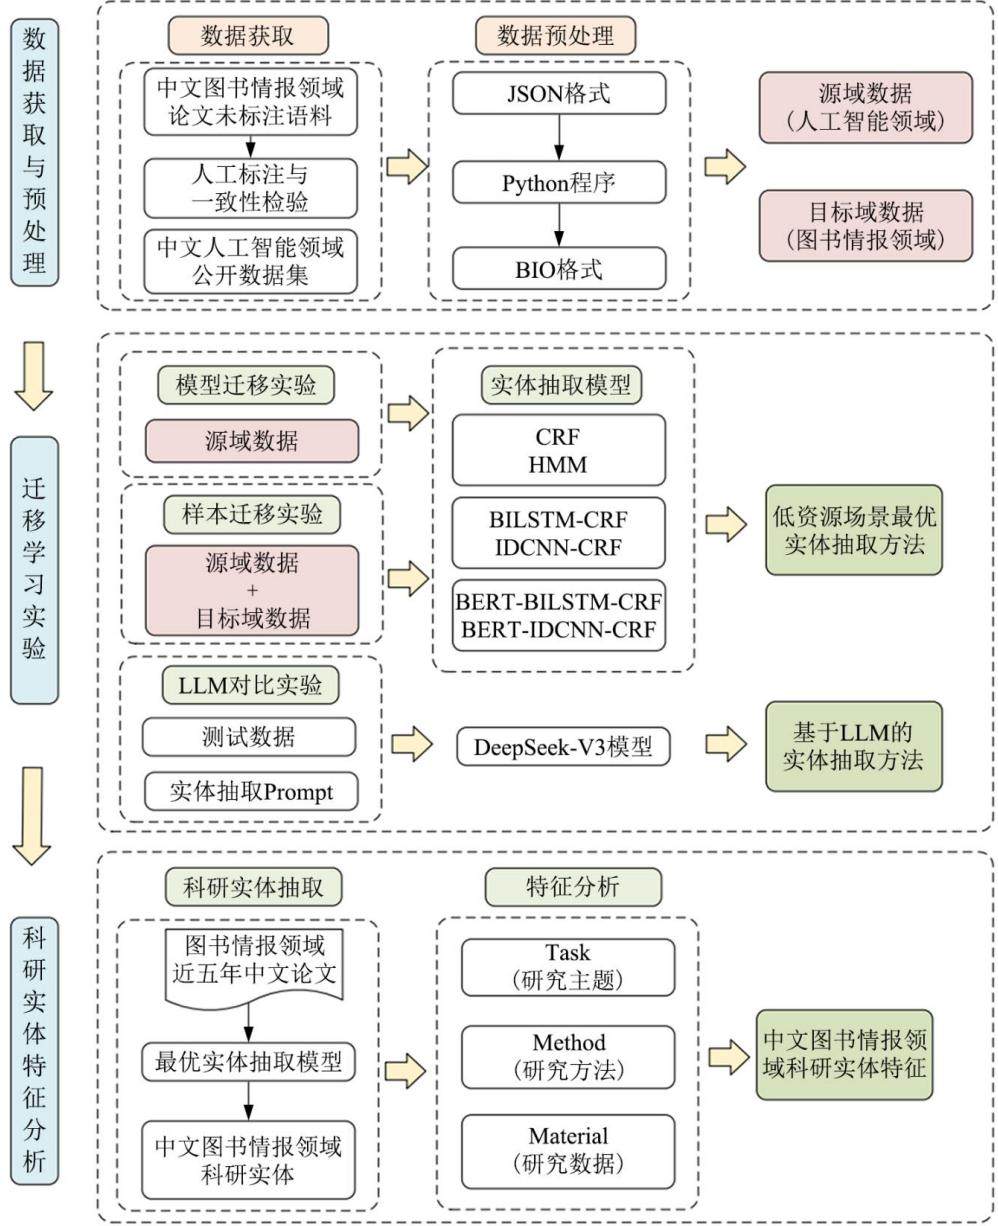
摘 要:[目的/意义] 本文探索迁移学习在图书情报领域科研实体抽取中的应用效果,以缓解低资源场景下的实体识别困境,揭示该领域科研实体的结构特征。[方法/过程] 以人工智能领域为源域、图书情报领域为目标域,构建跨领域迁移学习框架,在统一测试集上评估不同迁移策略的性能,并将最优模型应用于中文图书情报领域论文的科研实体抽取实证分析。[结果/结论] 实验结果表明,跨领域迁移学习方法整体性能优于小样本训练与
摘 要:[目的/意义] 典籍文献是文化遗产的核心组成部分,数字技术与人文研究的深度融合为典籍内容的活化利用提供了新机遇。《数智赋能的典籍内容知识重组理论与方法》一书系统构建了智能技术驱动的典籍内容知识重组理论、技术及应用体系,对推动数字人文研究、促进中华优秀传统文化创造性转化具有理论与现实价值。[方法/过程] 本文从理论体系、技术方法、应用场景和学术价值4个维度对该书进行评述,重点分析其在典籍知识表达、知识抽取及多元场景应用方面的贡献。[结果/结论] 该书深化了文化数字化背景下信息资源管理学科理论与方法,具有较高的学术价值与实践意义。
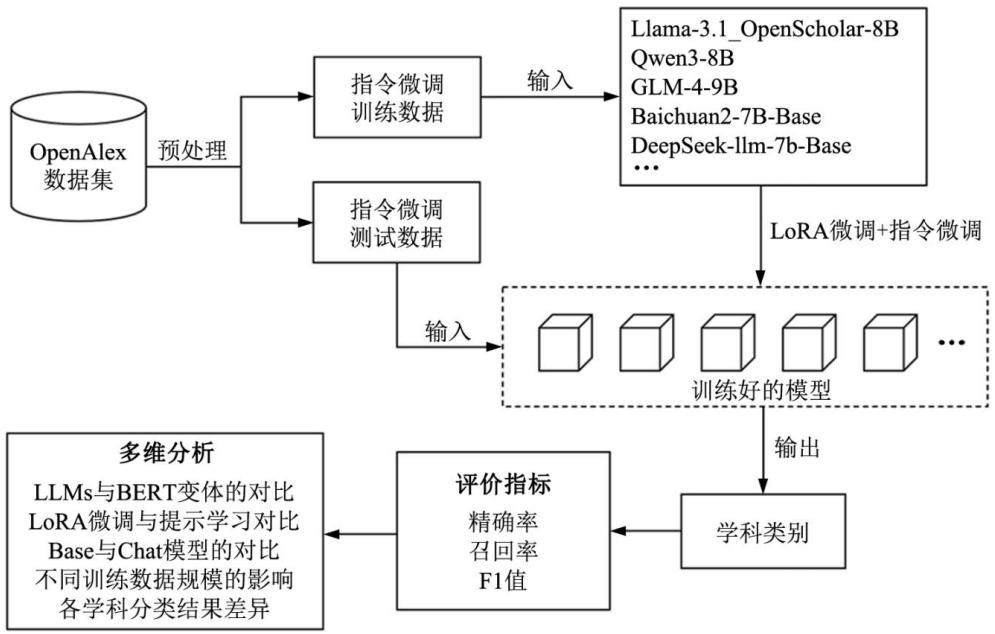
摘 要:[目的/意义] 传统文献分类方法在处理激增的学术文献时存在准确性不足、语义理解能力有限的问题,本研究探索了一种基于大语言模型(LLMs)的自动分类方法。[方法/过程] 选取Llama、DeepSeek等多个主流开源LLMs,采用低秩自适应(LoRA)与指令微调相结合的策略进行模型优化。基于OpenAlex数据库构建分类数据集,与传统深度学习模型和提示学习方法进行对比,并分析了不同模型架构及训练数据规模下的分类表现差异。[结果/结论] 所选LLMs在学术文献分类任务上全面优于传统模型,其中Llama-3.1_OpenScholar-8B取得最高F1值82.82%。小规模模型同样展现出良好分类能力,而针对对话任务优化的Chat模型与标准的Base模型在分类性能上的差异不大。即使在训练数据有限的场景下,LLMs仍表现出较强的分类潜力。
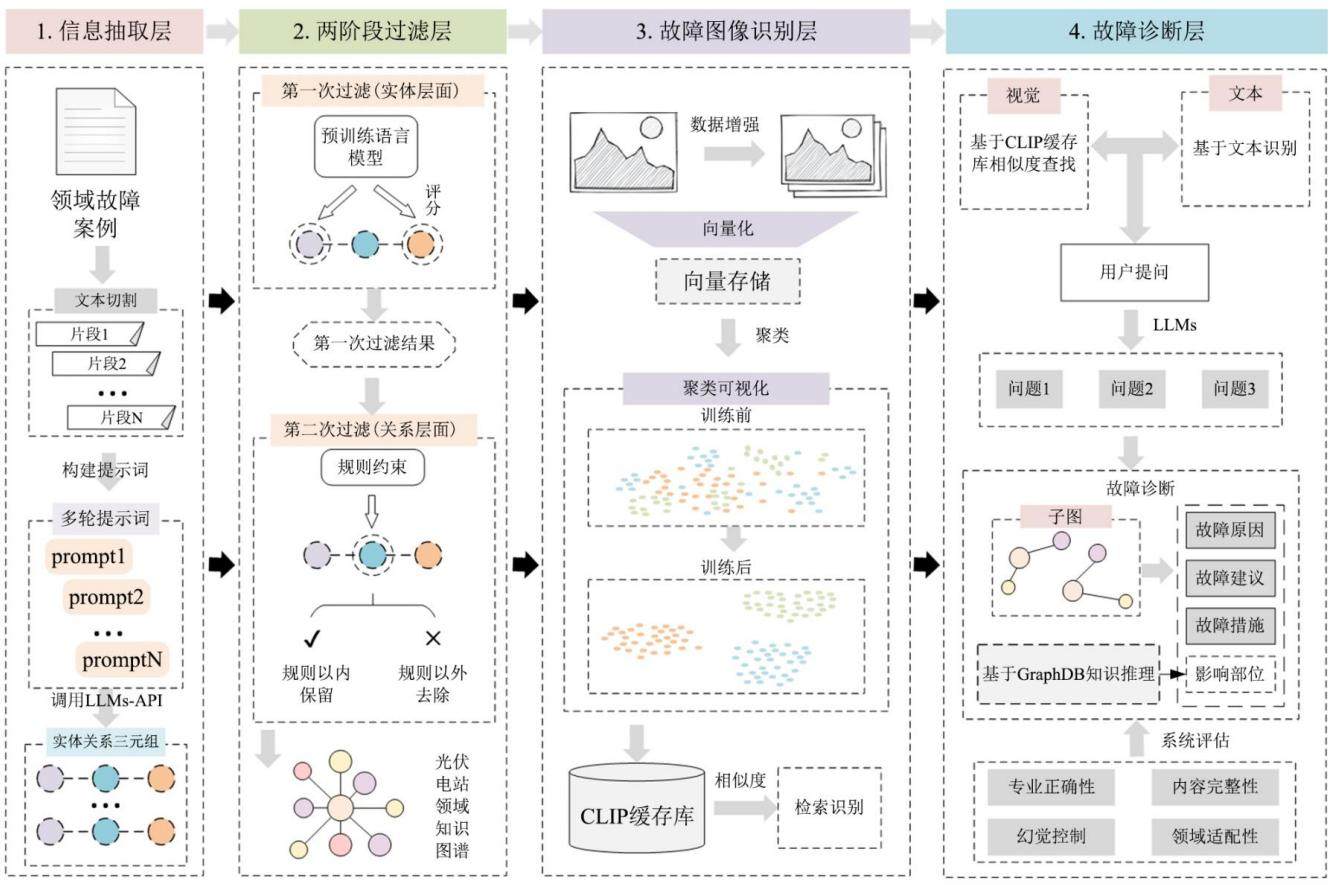
摘 要: [目的/意义] 针对领域知识碎片化、多模态信息协同不足及故障诊断依赖专家经验等问题, 本文提出一种融合大语言模型与多模态数据的领域故障识别与智能诊断框架。[方法/过程] 该框架面向领域故障案例文本与故障图像两类数据, 利用大模型抽取案例文本知识, 并通过 “实体置信度+规则约束” 两阶段过滤机制提升信息抽取质量, 构建高质量领域故障知识图谱; 进一步采用预训练 CLIP 模型对故障图像进行向量聚类与特征检索; 在文本及图像实体对齐的基础上, 结合子图检索与知识推理增强实现领域故障诊断策略的生成。[结果/结论] 以光伏电站运维场景开展实证研究, 结果表明: 两阶段过滤机制使信息抽取任务 F1 值提升 8.6%, 基于 CLIP 图像特征表示与缓存特征优化, 实现图像聚类轮廓系数提升 319.9%; 基于子图检索增强生成的诊断结果在专业正确性、内容完整性、幻觉控制和领域适配性方面较基于大模型的直接生成提升 49.80%, 本研究所提出的故障智能诊断框架有效提升了故障原因分析、解决方案及预防措施的准确性与可解释性, 为多领域故障智能诊断系统构建提供了可实施路径。
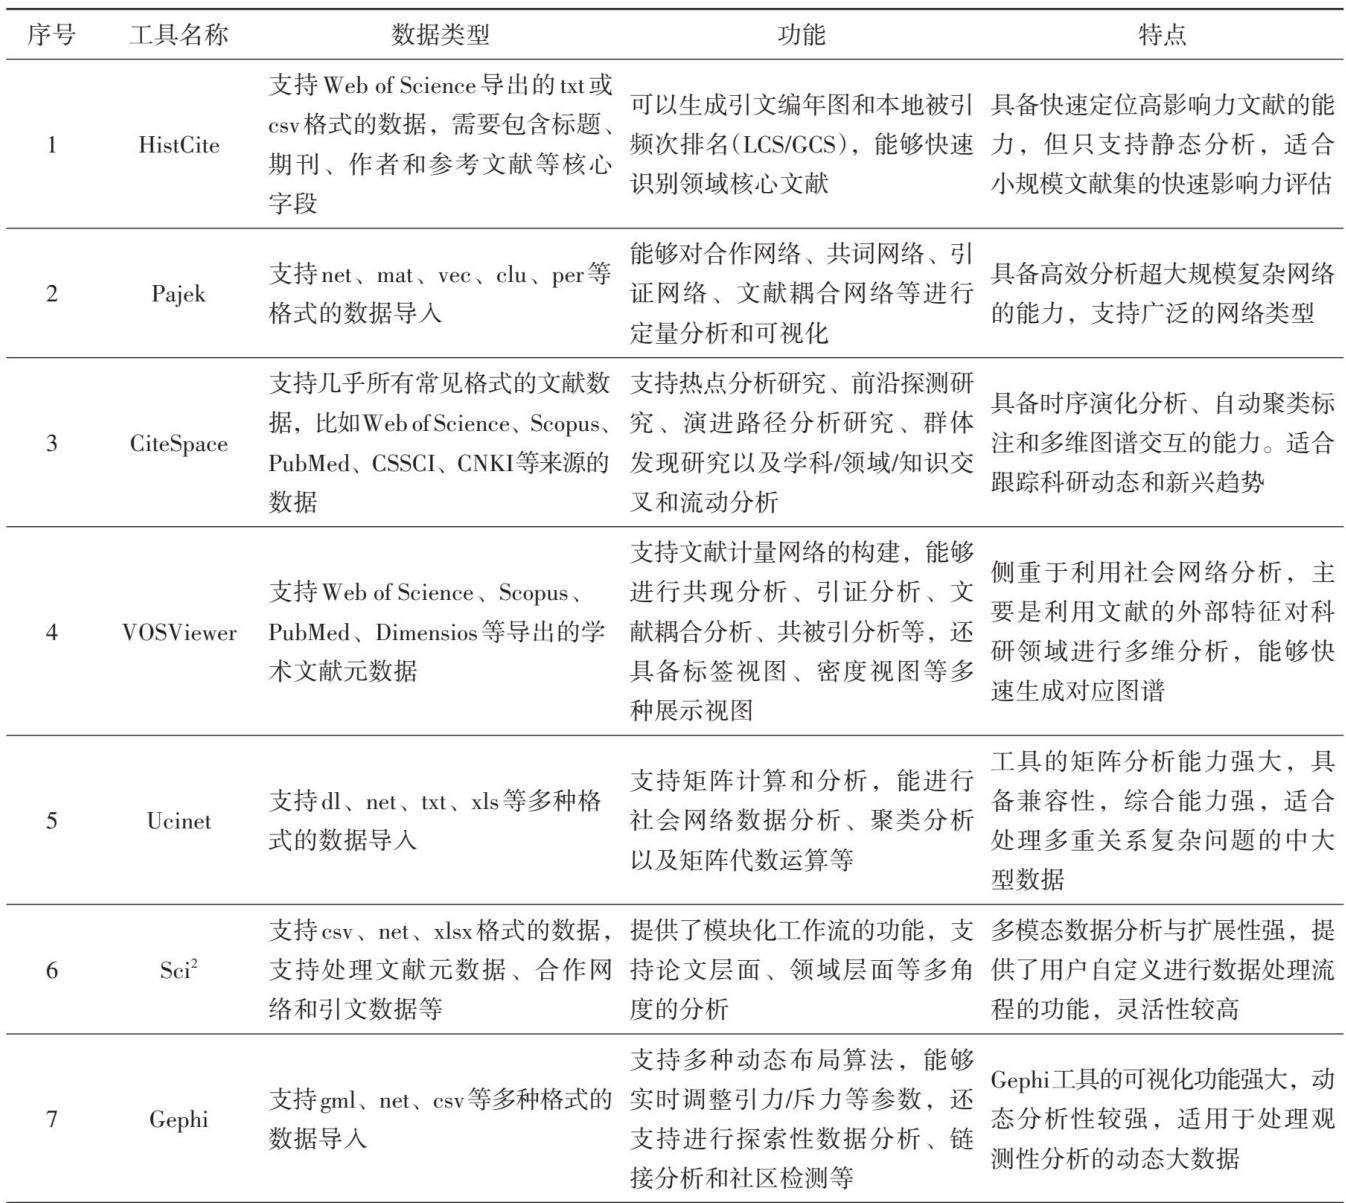
摘 要:[目的/意义] 现有画像工具以基于文献计量方法的外在特征揭示为主,但深入知识内容单元层面进行语义揭示较为不足。[方法/过程] 本研究旨在突破传统基于文献外部特征的科研领域画像范式,从科研领域的外在特征、内在结构、核心驱动力三维出发,基于科学计量方法、社会网络分析方法、科技文献语义内容深度挖掘方法等,设计融合领域结构画像、知识画像和状态画像三维画像方法体系并落地研发为工具。[结果/结论] 建成了对科研领域全面性和本质性描述工具—科研领域画像工具(SCIAITool: Mapping Tool),实现领域研究结构分析、领域知识结构揭示和领域发展状态研判功能,可以从一定程度上解决现有画像工具无法深入知识层面的问题,实现从“文献表层关联”到“内在知识关联”的跨越。
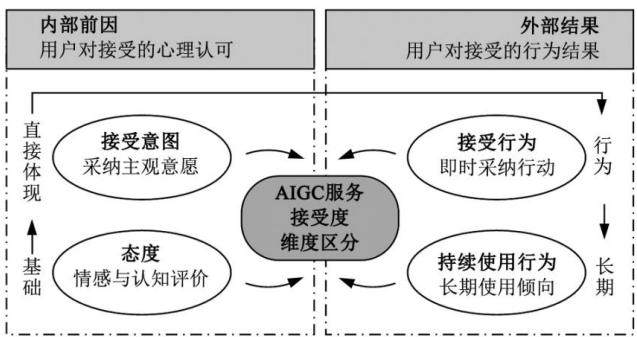
摘 要:[目的/意义] 现有研究显示,来自技术、用户和环境不同层面的因素对AIGC服务接受度的影响存在差距,本文基于前人实证研究进行定量化的文献综述分析,对全面厘清AIGC服务接受度的影响机理,为各类应用主体科学制定战略规划、管理决策与服务优化方案具有重要参考价值。[方法/过程] 采用元分析方法,基于171篇文献,探究上述3个层面29个因素对AIGC服务接受度的影响,并从用户接受度类型、情境因素和测量因素的角度分析AIGC服务接受度与影响因素间存在异质性的原因。[结果/结论] 结果表明,技术层面“有用性”、用户层面“AI应用、态度”和环境层面“匹配度、组织效能”与AIGC服务接受度之间有高度的正相关关系;“易用性、使用动机、便利条件”等19个变量具有中等的正相关关系,技术层面“拟人化”和用户层面“个人特质、伦理意识”有弱正相关关系;接受类型、态度类型、使用类型、AIGC应用领域、AI类型、文献类型、国家文化和发表年份对变量间关系具有调节作用。
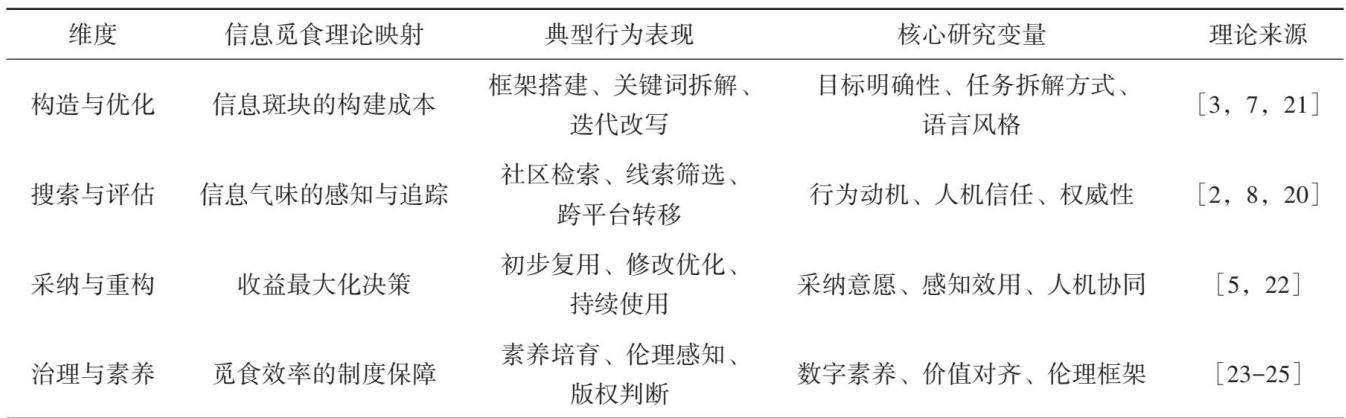
摘 要:[目的/意义] AIGC时代,提示词是连接用户需求与AI输出的核心媒介。本研究基于信息觅食理论,揭示提示词搜索场景下用户采纳行为的影响机理,明确“信息气味线索”的作用路径,为社区优化与决策效率提升提供支撑。[方法/过程] 构建“信息气味线索—生成效益感知—采纳行为”模型,选取结构复杂度、描述具体性、社区热度、创作者信誉四类线索,采用情景模拟问卷收集512份有效样本,运用结构方程模型验证假设。[结果/结论] 四类线索均显著正向影响生成效益感知,其中创作者信誉影响最强;生成效益感知在信息气味线索与采纳行为间发挥差异化中介作用(对结构复杂度、创作者信誉完全中介,对描述具体性、社区热度部分中介)。研究厘清了“线索预判—效益感知—行为落地”的决策链条,拓展了信息觅食理论在人智交互场景的应用。
摘 要: [目的/意义] 社会化问答社区为用户提供了交流知识、建立关系的重要平台, 而用户参与对于社区维系活跃度和长期发展具有重要意义。随着在线社区匿名性受到更多关注, 探究匿名与非匿名回答特征对用户参与的差异化影响, 有助于为社区完善交互及匿名机制提供参考。[方法/过程] 本研究从获取的知乎数据中提取回答的信息质量、情绪性及话题特征, 创新性地引入以网络密度测度的交流性指标来表征群体层面的用户参与, 并基于XGBoost构建SHAP可解释机器学习模型, 探究匿名回答和非匿名回答特征对用户参与的不同影响。[结果/结论] 匿名回答倾向于通过情绪路径吸引流量, 而非匿名回答更倾向于通过质量路径引发深度交流。本研究丰富了群体性层面的用户参与测度方式与研究视角, 通过可解释分析模型突破了传统回归分析难以捕捉非线性关系和黑箱模型可解释性差的局限, 有效揭示了匿名与非匿名回答对群体性用户参与的差异化影响路径。
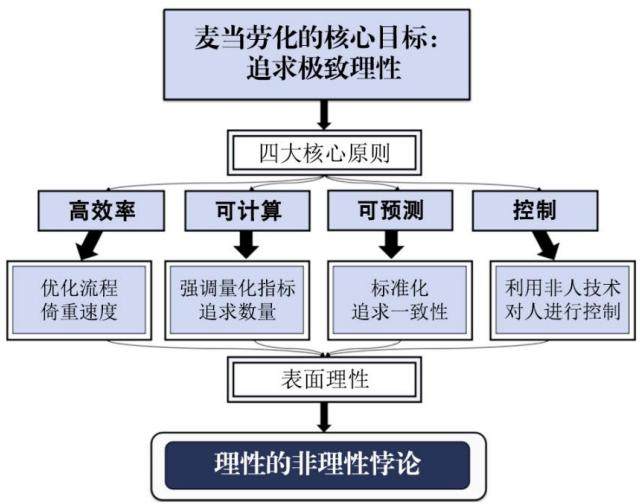
摘 要: [目的/意义] 数智技术在为大模型时代的科学数据开放共享赋能的同时, 也伴生了“麦当劳化”的风险与挑战, 在追求极致理性的同时出现“理性的非理性”悖论, 导致其背离服务科学创新的初衷。探究此异化现象及其矫治策略, 对构建健康、可持续的科学数据开放共享生态具有重要的理论与现实意义。[方法/过程] 以乔治·瑞泽尔的“麦当劳化”理论为分析框架, 依照规范研究范式, 系统审视了大模型时代科学数据开放共享在效率、可计算性、可预测性与控制4个维度的异化表征, 在此基础上提出矫治策略。[结果/结论] 针对效率至上、可计算性霸权、可预测理性、控制强化四大异化现象, 提出系统的矫治策略: 施行增强型元数据标准建设与智能封装工具开发结合方案, 确立 Data for Science 导向的数据贡献认证与权益反哺机制; 开发面向多元维度的价值评估体系, 设计“人在回路”的混合增强评估模式; 发展多源异构数据融合架构, 打造动态立体幻觉治理系统; 建设面向多方主体价值共创的可信数据空间, 建立基于多边共识的国际数据治理协作制度。
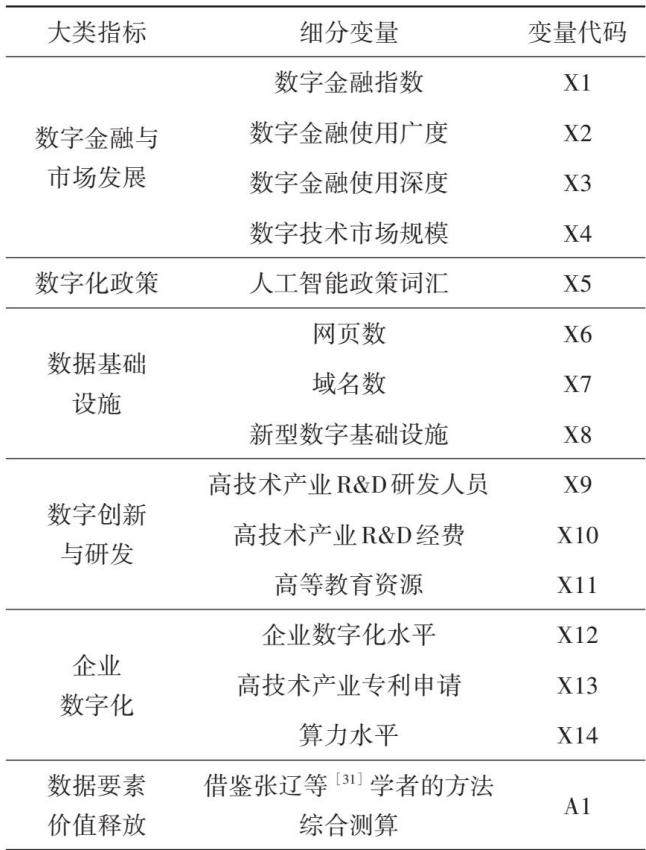
摘 要:[目的/意义] 分析影响中国公共数据要素价值释放的因素,更好地促进公共数据要素发挥作用。[方法/过程] 梳理相关政策,在确定五大类对公共数据要素价值释放产生影响的因素基础上,收集中国31个省份(不包含港、澳、台)2012—2023年的14个指标数据,采用XGBoost和SHAP方法对数据进行分析,通过预测结果图、特征概要图、特征重要性柱状图、因素热力图等来进行分析。[结果/结论] 研究发现,高技术产业R&D经费在XGBoost特征重要性排序和SHAP贡献排序中均居于核心位置,表明研发投入是推动公共数据要素价值释放的关键驱动因素;高技术产业专利申请与数字技术市场规模同样具有较高解释贡献,说明技术创新产出与市场需求扩张共同构成公共数据价值转化的重要支撑。SHAP特征概要图进一步表明,关键变量高值总体上对公共数据要素价值释放具有正向推动作用;依赖关系图显示,研发投入的影响并非简单线性增长,可能存在阶段性增强和边际变化特征;交互作用结果则揭示,公共数据要素价值释放并非由单一因素独立决定,而是创新投入、技术产出、市场承接、基础设施和企业数字化能力等多重因素协同作用的结果。由此可见,提升公共数据要素价值释放水平,应从强化研发投入、促进技术成果转化、扩大数字技术市场需求和完善多因素协同机制等方面系统推进。
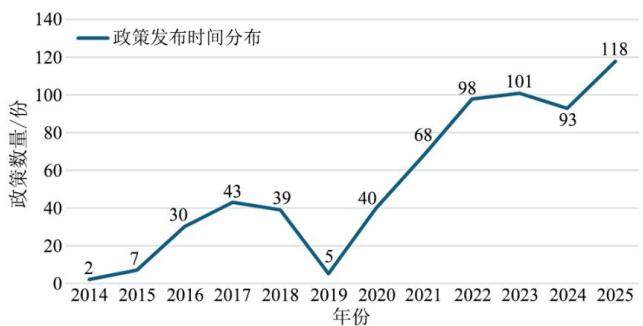
摘 要:[目的/意义] 研究数据交易的地方政策内容体系,旨在明确各地数据交易政策指引的实际进展与优化方向,进而推进数据要素相关理论与方法的发展。[方法/过程] 运用扎根理论,对中国有关数据交易的644份地方数据政策的文本内容进行分析。[结果/结论] 研究发现,中国数据交易有关政策内容体系已经在机构建设、制度规范、流程设计、相关者培育、流通利用与协同机制等方面展开了建构,但在内容结构、区域分布、政策协同等方面仍存在不足。据此提出优化路径:以地方相互参照为基础优化地方个体政策体系;立足政策体系内容框架明晰深化方向;在央地一体化导向下加强地方政策跟进;基于理论实践探索进程持续优化政策内容体系。